In 2022 verhuisden veel Oekraïense overheidsinstanties, staatsbedrijven en gereguleerde ondernemingen hun informatiesystemen naar Microsoft Azure, AWS en andere publieke clouds in het buitenland, om ze onder de staat van beleg draaiende te houden. Dat werkte — maar de back-ups van de meeste van die systemen staan nog altijd in dezelfde cloud, bij dezelfde provider en vaak in dezelfde regio. Wordt het account geblokkeerd, valt de regio uit of bemachtigt een aanvaller beheerdersrechten, dan verdwijnen productie en alle herstelpunten in één klap.
Een onafhankelijke herstelreserve dicht dat gat: een onveranderbare, versleutelde kopie van elk kritiek systeem, bewaard in een gecertificeerd datacenter in Oekraïne, dagelijks ververst en volgens een vast schema getest. In dit artikel leest u welke referentiearchitectuur wij daarvoor inzetten, hoe u de reserve dimensioneert, wat die kost en hoe u alles in ongeveer 40 dagen uitrolt.
Waarom de ingebouwde cloudback-up geen onafhankelijke reserve is
De ingebouwde back-updiensten van cloudplatforms zijn uitstekend voor alledaagse restores, maar ze delen het lot van het platform dat ze beschermen. Azure Backup bewaart herstelpunten in een Recovery Services vault die bij hetzelfde abonnement en dezelfde tenant hoort; bij lokaal redundante opslag (LRS) staan alle kopieën in één regio. AWS Backup-vaults werken volgens hetzelfde patroon.
- Eén provider, één faaldomein. Een opgeschort account, een factuurgeschil, een sanctiebesluit of een regionale storing haalt productie én back-ups op hetzelfde moment offline.
- Dezelfde identiteiten. Een gecompromitteerde globale beheerder kan back-upbeleid wijzigen, bewaartermijnen inkorten of voorlopig verwijderde items definitief wissen — tenzij elke beveiliging tot in de puntjes is geconfigureerd.
- Geen exportroute. Herstelpunten van Azure Backup kunnen niet als bestanden worden geëxporteerd. De enige manier om de data eruit te krijgen, is de schijven van één herstelpunt terugzetten en volledig downloaden — elke keer opnieuw.
Dat laatste punt bepaalt het hele project: u kunt niet zomaar ‘de bestaande back-ups overzetten’ naar een ander datacenter. Een onafhankelijke reserve vraagt om een eigen back-upketen — één volledige kopie, daarna dagelijkse incrementele back-ups — die wordt weggeschreven naar opslag waarover de cloudprovider geen zeggenschap heeft.
Wat de Oekraïense regelgeving verlangt van systemen met hoge impact
De Oekraïense regels wijzen dezelfde kant op. De verplichte eisen voor informatiesystemen, vastgesteld bij kabinetsbesluit nr. 205 van 21 februari 2025, verlangen van eigenaren van systemen in categorie I en II een herstelreserve die onafhankelijk is van de primaire bedrijfsomgeving.
Kabinetsbesluit nr. 263 van 12 maart 2022 maakt het mogelijk om informatiebronnen van de overheid tijdens de staat van beleg in buitenlandse clouds te hosten, en verplicht overheidsinstanties daar binnen zes maanden na afloop ervan mee te stoppen. Een actuele kopie in Oekraïne is in de praktijk de basisvoorwaarde voor die terugkeer.
Ook waar de reserve mag staan, is gereguleerd. Op grond van de Oekraïense wet ‘Inzake clouddiensten’ en kabinetsbesluit nr. 154 van 11 februari 2025 nemen overheidsinstanties cloud- en datacenterdiensten af van providers op de officiële lijst die wordt bijgehouden door de Staatsdienst voor Speciale Communicatie en Informatiebescherming van Oekraïne (SSSCIP). Medio 2026 stonden De Novo, GigaCloud, DataPark en UCloud op die lijst — alle vier exploiteren ze cloudinfrastructuur met een gecertificeerd KSZI (Oekraïens geïntegreerd informatiebeveiligingssysteem).
Kortom: een onafhankelijke kopie in een KSZI-gecertificeerde cloud in Oekraïne dicht het gat in de weerbaarheid, voldoet aan de reserve-eis voor systemen in categorie I–II en effent de weg terug uit buitenlandse clouds.
Referentiearchitectuur: twee onveranderbare kopieën in Oekraïne
Het ontwerp laat de ingebouwde cloudback-up ongemoeid en voegt een aparte, onafhankelijke keten toe die in Oekraïne eindigt.
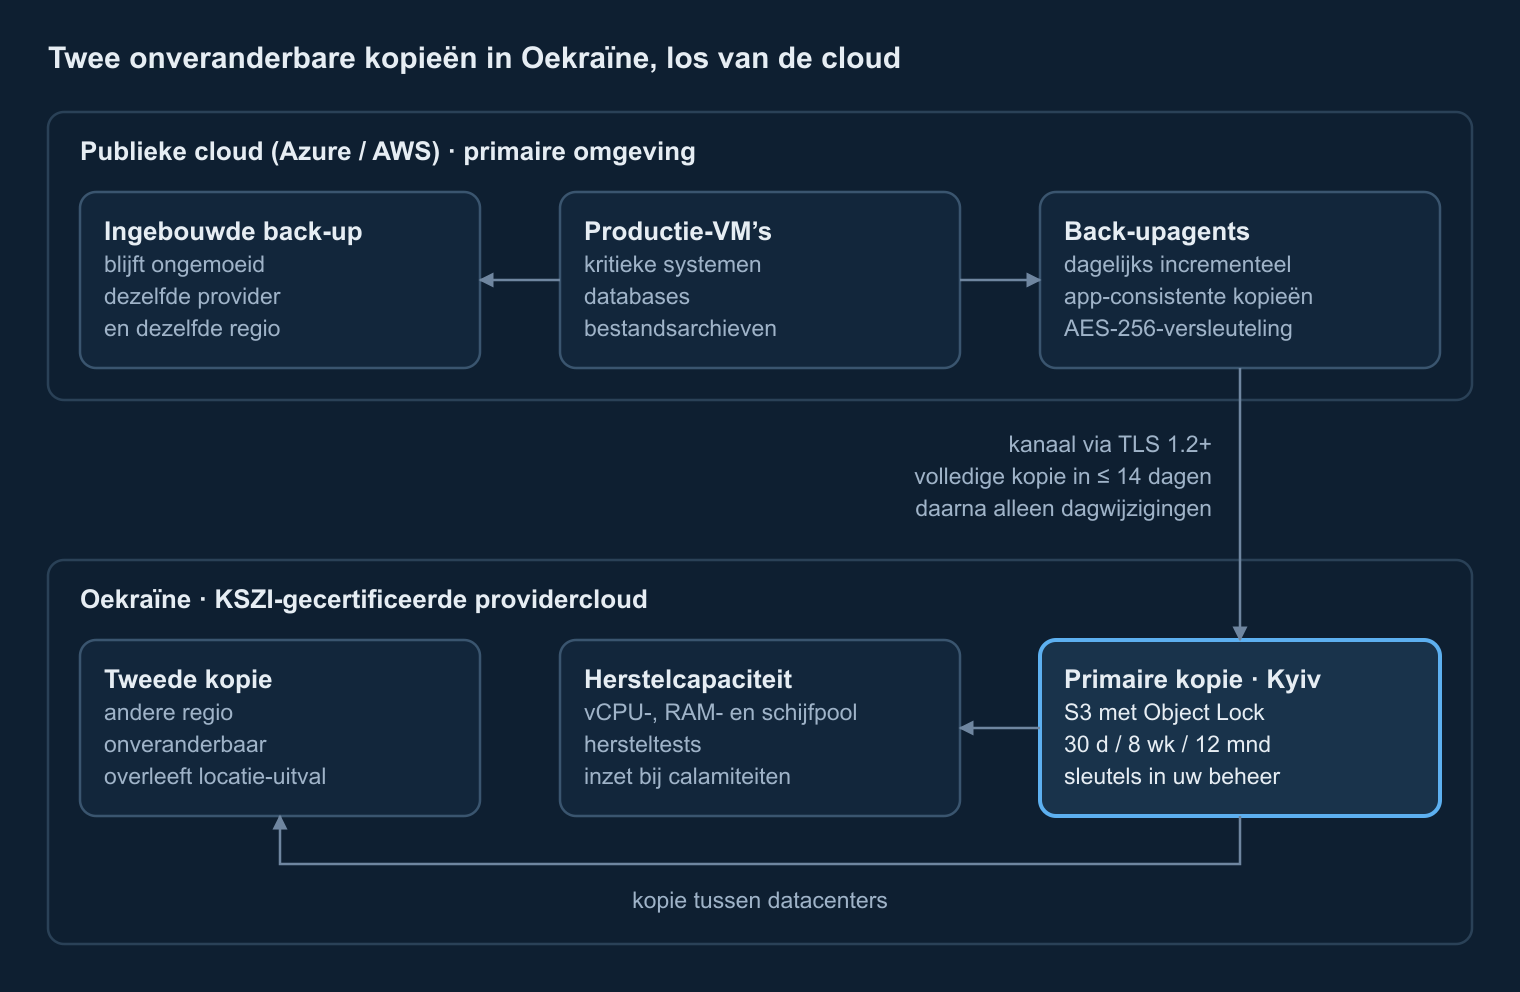
- Back-upagents in de cloud. Veeam-agents (of Veeam Backup for Microsoft Azure) draaien naast elke beschermde VM en maken applicatieconsistente kopieën van Oracle-, Microsoft SQL Server- en PostgreSQL-databases. De data wordt gecomprimeerd en met AES-256 versleuteld voordat die de VM verlaat.
- Versleuteld transport. Kopieën gaan via TLS 1.2+ naar een S3-compatibel endpoint in Oekraïne. De eerste volledige kopie wordt binnen twee weken overgezet (seeding); daarna gaan alleen de dagelijkse wijzigingen over de lijn.
- Primaire onveranderbare kopie. Een S3-bucket met Object Lock in compliancemodus (WORM) houdt elk herstelpunt gedurende de volledige bewaartermijn onveranderbaar — zelfs beheerders kunnen het niet verwijderen.
- Tweede kopie in een andere regio. Herstelpunten worden gerepliceerd naar een datacenter in een andere Oekraïense regio, zodat het verlies van één locatie niet het verlies van de reserve betekent.
- Herstelcapaciteit. Een pool van vCPU, RAM en schijfruimte naast de opslag wordt gebruikt voor geplande hersteltests en, als het nodig is, om systemen zonder de cloud in Oekraïne op te starten.
Identiteiten zijn bewust gescheiden: back-upaccounts hebben hun eigen multifactorauthenticatie en zijn niet gefedereerd met uw Microsoft Entra ID, zodat een gecompromitteerde cloudtenant geen weg naar de kopieën biedt. De encryptiesleutels blijven in uw beheer.
Bewaarbeleid en dimensionering van de opslag
De benodigde capaciteit hangt af van de omvang van één volledige kopie, de dagelijkse wijzigingsgraad en het bewaarbeleid. Een grootvader-vader-zoonschema (GFS) met 30 dagelijkse, 8 wekelijkse en 12 maandelijkse herstelpunten is een gangbaar doel voor systemen in categorie I; een lichter beleid van 14 dagen / 4 weken volstaat voor minder kritieke workloads.
| Parameter | Voorbeeldwaarde | Waarom het telt |
|---|---|---|
| Gebruikte data (niet de toegewezen schijven) | 20 TB | Bepaalt de omvang van de volledige kopie |
| Datareductie | 1,5× | Volledige kopie ≈ 13,3 TB op de opslag |
| Dagelijkse wijziging na reductie | 200 GB | Omvang van elk dagelijks herstelpunt |
| Bewaarbeleid | 30 d / 8 wk / 12 mnd | Aantal bewaarde herstelpunten |
| Resultaat incl. overhead en 15% groei | ≈ 42 TB | tegenover ≈ 22 TB bij 14 d / 4 wk |
De meest gemaakte fout is de reserve te dimensioneren als ‘één kopie van de schijven’. Bij een bewaarbeleid van 12 maanden kan de historie even groot worden als de volledige kopie zelf. Onze stapsgewijze handleiding voor dimensionering geeft de formules en een uitgewerkt rekenvoorbeeld.
Waar de kosten zitten
Een reserve in Oekraïne kent vier kostenposten. Als u die vooraf kent, blijft uw budgetaanvraag eerlijk.
- Opslag per TB per maand in de KSZI-gecertificeerde cloud van de provider, voor de primaire en de tweede kopie. Doorgaans wordt het werkelijke gemiddelde volume per maand gefactureerd.
- Eenmalige diensten: ontwerp en inrichting van de back-upketen, seeding van de volledige kopie en de eerste ronde hersteltests.
- Herstelcapaciteit per maand gebruik — voor tests en voor herstel in noodsituaties.
- Cloud-egress (uitgaand dataverkeer), gefactureerd door de cloudprovider. Tegen de Azure-lijstprijzen voor Europa kosten de eerste 10 TB per maand $ 0,087 per GB en de volgende 40 TB $ 0,083 per GB. De seeding van 25 TB kost dus zo’n $ 2.100, en 6–15 TB aan maandelijkse wijzigingen $ 500–1.300.
Compressie, deduplicatie en tarieven met routeringsvoorkeur kunnen de egresspost met een derde of meer verlagen. Valt het cloudabonnement onder een sponsorprogramma, dan is de egress mogelijk al betaald.
Hersteltests en herstelcapaciteit
Een kopie die nog nooit is teruggezet, is geen reserve maar hoop. Wij zetten elk beschermd systeem terug na de initiële seeding en herhalen volledige tests minstens eenmaal per jaar, waarbij we de gemeten hersteltijd (RTO) en het herstelpunt (RPO) vastleggen.
Voor de grootste systemen — doorgaans een documentmanagementsysteem op twee servers of een ERP-database — heeft de herstelpool genoeg schijfruimte nodig voor de volledige dataset en voor twee VM’s die tegelijk draaien. Een pool van 32 vCPU, 128 GB RAM en 20 TB schijfruimte volstaat voor de meeste middelgrote organisaties en doet tevens dienst als noodomgeving als de cloud onbereikbaar wordt.
Uitrolplan in 40 dagen
- Dag 0–5. Toegang, opslagbuckets met Object Lock, back-upserver, versleuteling, MFA en auditlogging.
- Dag 5–19. Eerste volledige kopie van elke beschermde VM; de dagelijkse incrementele back-ups starten zodra de eerste kopie van een VM gereed is.
- Dag 19–26. Replicatie naar de tweede regio en verificatie van de kopieketen.
- Dag 26–40. Hersteltests van elk systeem, testprotocollen, back-upbeleid en disaster-recoveryplan.
- Daarna elke maand. Monitoring, integriteitscontroles en een rapport over geslaagde jobs, volumes en incidenten.
Wat u krijgt bij Corvus Intelligence
- Een gedocumenteerde architectuur en een back-upbeleid dat aansluit op de reserve-eis voor systemen in categorie I–II.
- Onveranderbare primaire en secundaire kopieën in KSZI-gecertificeerde clouds van providers op de SSSCIP-lijst.
- Hersteltests met protocollen en een disaster-recoveryplan dat uw team zelf kan uitvoeren.
- 24/7-monitoring van back-upjobs en een SLA met een responstijd van één uur bij kritieke incidenten.
- Transparante eenheidsprijzen — per TB, per maand herstelcapaciteit en per eenmalige dienst — direct bruikbaar voor een budgetaanvraag.
De reserve gaat uitstekend samen met continue beveiligingsmonitoring: ons managed SOC op Security Onion bewaakt back-upevents samen met de rest van de infrastructuur en slaat alarm bij elke poging om ermee te knoeien.
Vraag een capaciteits- en kostenraming aan voor uw reserve
Stuur ons de lijst met systemen en datavolumes — u ontvangt van ons een architectuur, een raming voor opslag en egress en een uitrolplan.
Deze gids is opgesteld door engineers van Corvus Intelligence die back-up, disaster recovery en beveiligingsmonitoring ontwerpen voor overheidsorganisaties en organisaties in de vitale infrastructuur. Over Corvus Intelligence →